RAG开发——下
chain链
「将组件串联,上一个组件的输出作为下一个组件的输入」是 LangChain 链(尤其是 | 管道链)的核心工作原理,这也是链式调用的核心价值:实现数据的自动化流转与组件的协同工作,如下。
chain = prompt_template | model
核心前提:即 Runnable 子类对象才能入链(以及 Callable、Mapping 接口子类对象也可加入(后续了解用的不多))。
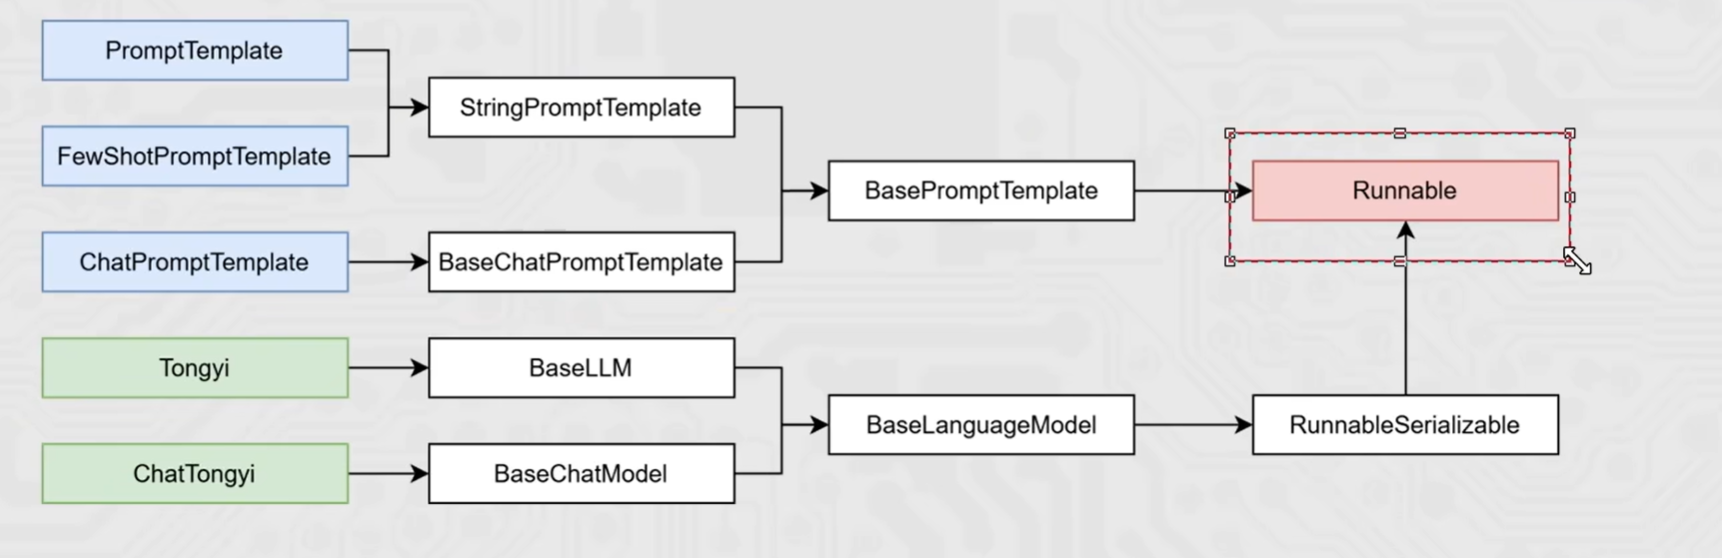
我们目前所学习到的组件,均是 Runnable 接口的子类,如下类的继承关系:
 通过|链接提示词模板对象和模型对象
返回值chain对象是RunnableSerializable对象
是Runnable接口的直接子类
也是绝大多数组件的父类
通过invoke或stream进行阻塞执行或流式执行
组成的链在执行上有:上一个组件的输出作为下一个组件的输入的特性.(可以链接许多组件,比如连续链接多个模型)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| from langchain_core.prompts import ChatPromptTemplate,MessagesPlaceholder
from langchain_community.chat_models.tongyi import ChatTongyi
chat_prompt_template = ChatPromptTemplate.from_messages(
[
("system", "你是一个边塞诗人,可以作诗。"),
MessagesPlaceholder("history"),
("human", "请再来一首唐诗"),
]
)
history_data = [
("human", "你来写一个唐诗"),
("ai", "床前明月光,疑是地上霜,举头望明月,低头思故乡"),
("human", "好诗再来一个"),
("ai", "锄禾日当午,汗滴禾下锄,谁知盘中餐,粒粒皆辛苦"),
]
model = ChatTongyi(model="qwen3-max",streaming=True)
# 组成链,要求每一个组件都是Runnable接口的子类
chain = chat_prompt_template | model
# 通过链去调用invoke或stream
# res = chain.invoke({"history": history_data})
# print(res.content)
# 通过stream流式输出
for chunk in chain.stream({"history": history_data}):
print(chunk.content, end="", flush=True)
|
RunnableSequence
RunnableSequence = 用 | 连接多个组件后,生成那个「链条对象」
它是 LangChain 链的官方学名
chain = prompt | model | parser得到的 chain 数据类型就是:RunnableSequence
所谓 | 管道符,本质就是:创建了一个 RunnableSequence 对象
1
2
| 运行
chain = prompt | model | parser
|
等同于官方写法:
1
2
3
4
| 运行
from langchain_core.runnables import RunnableSequence
chain = RunnableSequence(prompt, model, parser)
|
StrOutputParser字符串输出解析器
有如下代码,以第一次的输出结果去询问第二给模型
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
| from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi
model = ChatTongyi(model="qwen3-max")
prompt = PromptTemplate.from_template(
"我邻居姓: {lastname}, 刚生了{gender}, 请起名, 仅告知名字无需其它内容"
)
chain = prompt | model | model
res = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res.content)
|
链的构建完全符合要求(参与的组件)
但是运行报错(ValueError: Invalid input type <class ’langchain_core.messages.ai.AIMessage’>. Must be a PromptValue, str, or list of BaseMessages.)
这是因为第一次model输出结果是:AIMessage,但是第二次model需要接受的类型不能是AIMessage,导致的报错。
所以我们此时要通过StrOutputParser字符串输出解析器,可以将AIMessage解析为简单的字符串,符合了模型invoke方法的要求。
如下
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
| from langchain_core.output_parsers import StrOutputParser
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.prompts import PromptTemplate
parser = StrOutputParser()
model = ChatTongyi(model="qwen3-max")
prompt = PromptTemplate.from_template(
"我邻居姓:{lastname},刚生了{gender},请起名"
)
chain = prompt | model | parser |model
res = chain.invoke({"lastname":"张","gender":"女儿"})
print(res.content )
|
JsonOutputParser
我们运行代码后发现上一个模型的输出没有被处理就给了第二个模型,导致第二次是对第一次的回答直接回答,索要的结果不是我们想要的结果
所以我们在给第二次模型调用之前还需要对其进行处理
所以我们需要完成:
将模型输出的AIMessage->转为字典->注入第二个提示词模板中,形成新的提示词
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| from langchain_core.output_parsers import StrOutputParser
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi
str_parser = StrOutputParser()
json_parser = JsonOutputParser()
model = ChatTongyi(model="qwen3-max")
first_prompt = PromptTemplate.from_template(
"我邻居姓: {lastname}, 刚生了{gender}, 请起名, 并封装到JSON格式返回给我, "
"要求key是name, value就是起的名字。请严格遵守格式要求"
)
second_prompt = PromptTemplate.from_template(
"姓名{name}, 请帮我解析含义。"
)
chain = first_prompt | model | json_parser | second_prompt | model | str_parser
res: str = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res)
print(type(res))
|
其中
"我邻居姓: {lastname}, 刚生了{gender}, 请起名, 并封装到JSON格式返回给我, "
"要求key是name, value就是起的名字。请严格遵守格式要求"
通过在提示词中做文章让输出的值强制为JSON格式,否则可能会报错。
其转化过程可能为

RunnambeLambda
将普通函数转化为Runnable接口实例,方便自定义函数加入Chain
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableLambda
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi
str_parser = StrOutputParser()
my_func = RunnableLambda(lambda ai_msg: {"name": ai_msg.content})
model = ChatTongyi(model="qwen3-max")
first_prompt = PromptTemplate.from_template(
"我邻居姓: {lastname}, 刚生了{gender}, 请起名, 仅告知我名字, 不要额外信息"
)
second_prompt = PromptTemplate.from_template(
"姓名{name}, 请帮我解析含义。"
)
chain = first_prompt | model | my_func | second_prompt | model | str_parser
res: str = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res)
print(type(res))
|
当然,跳过RunnableLambda直接让函数加入链也是可以的。因为 Runnable接口在实现_or_的时候,支持Callable接口的实例,而函数就是Callable接口的实例。即它会自动完成转化动作。
临时记忆
LangChain内置了历史记录附加功能,帮助模型在有历史记忆的情况下回答
1
2
3
4
5
6
7
8
9
| from langchain_core.runnables.history import RunnableWithMessageHistory
# 通过RunnableWithMessageHistory获取一个新的带有历史记录功能的chain
conversation_chain = RunnableWithMessageHistory(
some_chain, # 被附加历史消息的Runnable, 通常是chain
None, # 获取指定会话ID的历史会话的函数
input_messages_key="input", # 声明用户输入消息在模板中的占位符
history_messages_key="chat_history" # 声明历史消息在模板中的占位符
)
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
| # 获取指定会话ID的历史会话记录函数
chat_history_store = {} # 存放多个会话ID所对应的历史会话记录
# 函数传入为会话ID(字符串类型)
# 函数要求返回BaseChatMessageHistory的子类
# BaseChatMessageHistory类专用于存放某个会话的历史记录
# InMemoryChatMessageHistory是官方自带的基于内存存放历史记录的类
def get_history(session_id):
if session_id not in chat_history_store:
# 返回一个新的实例
chat_history_store[session_id] = InMemoryChatMessageHistory()
return chat_history_store[session_id]
|
RunnableWithMessageHistory 是 LangChain 内 Runnable 接口的实现,主要用于:
- 创建一个带有历史记忆功能的 Runnable 实例(链)
它在创建的时候需要提供一个 BaseChatMessageHistory 的具体实现(用来存储历史消息)
- InMemoryChatMessageHistory 可以实现在内存中存储历史
额外的,如果想要在 invoke 或 stream 执行链的同时,将提示词 print 出来,可以在链中加入自定义函数实现。
- 注意:函数的输入应原封不动返回出去,避免破坏原有业务,仅在 return 之前,print 所需信息即可。
长期记忆
使用InMemoryChatMessageHistory仅可以在内存中临时存储会话记忆,一旦程序退出,则记忆丢失。
InMemoryChatMessageHistory类继承自BaseChatMessageHistory。
但是我们可以自行实现一个基于Json格式和本地文件的会话数据保存。
基于文件存储会话系统记录,以Session_id为文件名。
通过继承BaseChatMessageHistory实现如下三个方法:
- add_messages:同步模式,添加消息
- messages:同步模式,获取消息
- clear:同步模式,清除消息
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
| import os
import json
from typing import Sequence
from langchain_core.messages import message_to_dict, messages_from_dict, BaseMessage
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables.history import RunnableWithMessageHistory
class FileChatMessageHistory(BaseChatMessageHistory):
def __init__(self, session_id, storage_path):
self.session_id = session_id
self.storage_path = storage_path
self.file_path = os.path.join(self.storage_path, f"{self.session_id}.json")
os.makedirs(self.storage_path, exist_ok=True)
def add_messages(self, messages: Sequence[BaseMessage]) -> None:
all_messages = list(self.messages)
all_messages.extend(messages)
new_messages = [message_to_dict(msg) for msg in all_messages]
with open(self.file_path, "w", encoding="utf-8") as f:
json.dump(new_messages, f, ensure_ascii=False, indent=2)
@property
def messages(self) -> list[BaseMessage]:
try:
# ✅ 这里必须是 "r" 读模式!!!
with open(self.file_path, "r", encoding="utf-8") as f:
message_data = json.load(f)
return messages_from_dict(message_data)
except FileNotFoundError:
return []
def clear(self) -> None:
with open(self.file_path, "w", encoding="utf-8") as f:
json.dump([], f)
def print_prompt(full_prompt):
print("=" * 20, full_prompt.to_string(), "=" * 20)
return full_prompt
model = ChatTongyi(model="qwen3-max")
prompt = PromptTemplate.from_template(
"你需要根据对话历史回应用户问题。对话历史: {chat_history}。用户当前输入: {input}, 请给出回应"
)
base_chain = prompt | print_prompt | model | StrOutputParser()
def get_history(session_id):
return FileChatMessageHistory(session_id, "./chat_history")
conversation_chain = RunnableWithMessageHistory(
base_chain,
get_history,
input_messages_key="input",
history_messages_key="chat_history"
)
if __name__ == '__main__':
session_config = {"configurable": {"session_id": "user_001"}}
res = conversation_chain.invoke({"input": "小明有两个猫"}, session_config)
print("第一次执行", res)
res = conversation_chain.invoke({"input": "小刚有一只狗"}, session_config)
print("第二次执行", res)
# res = conversation_chain.invoke({"input": "总共有几个宠物"}, session_config)
# print("第三次执行", res)
|
Document Loaders 文档加载器
文档加载器提供了一套标准接口,用于将不同来源(如 CSV、PDF 或 JSON 等)的数据读取为 LangChain 的文档格式。这确保了无论数据来源如何,都能对其进行一致性处理。
文档加载器(内置或自行实现)需实现 BaseLoader 接口。
Class Document,是 LangChain 内文档的统一载体,所有文档加载器最终返回此类的实例。
一个基础的 Document 类实例,基于如下代码创建:
1
2
3
4
5
| from langchain_core.documents import Document
document = Document(
page_content="Hello, world!", metadata={"source": "https://example.com"}
)
|
可以看到,Document 类其核心记录了:
- page_content: 文档内容
- metadata: 文档元数据(字典)
不同的文档加载器可能定义了不同的参数,但是其都实现了统一的接口(方法)
- load():一次性加载全部文档
- lazy_load():延迟流式传输文档,对大型数据集很有用,避免内存溢出。
一个简单的 CSVLoader 的使用示例如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
| from langchain_community.document_loaders.csv_loader import CSVLoader
loader = CSVLoader(
... # 初始化参数
)
# 一次性加载全部文档
documents = loader.load()
# 对于大数据集,分段返回文档
for document in loader.lazy_load():
print(document)
|
LangChain内置了许多文档加载器,详见官方文档
Vrctor stores 向量存储,基于向量并构建提示词
烂尾ing…
RunnablePassthrough
烂尾ing…