大模型部分
LLM:
LLM 全称 Large Language Model,中文译为大语言模型。
基于海量文本数据训练,可实现自然语言理解、文本生成、逻辑推理、代码编写、问答创作等功能,常见模型包含GPT、文心一言、通义千问、讯飞星火、豆包等。
Prompt
Prompt 中文称作提示词,是用户向大语言模型下达的指令、提问、描述文本。
通过设定文字要求,引导LLM按照指定风格、格式、逻辑完成生成、问答、创作、翻译等任务。
Context
Context即上下文,指对话过程中历史问答、输入文本、背景信息等全部内容。
LLM依托上下文理解语义、承接对话逻辑,连贯完成多轮交互与长文本任务。
Memory
Memory意为记忆,是大模型存储对话历史、用户偏好、过往交互数据的模块。
用于留存过往信息,实现连续对话、个性化应答与历史内容复用。
智能体部分
RAG
RAG(Retrieval-Augmented Generation)即检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。可以总结为一个公式:RAG = 检索技术 + LLM 提示
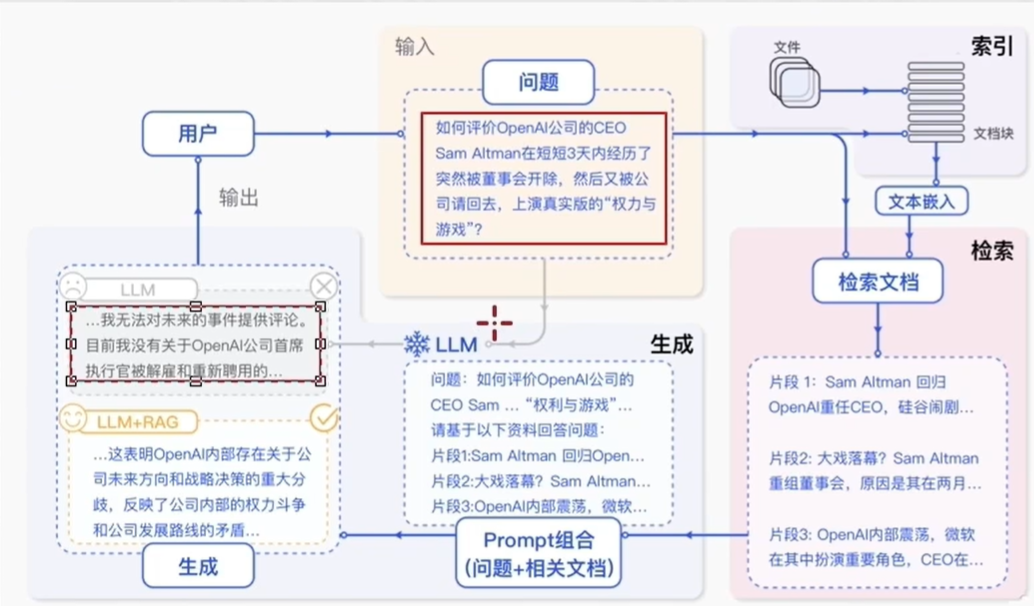
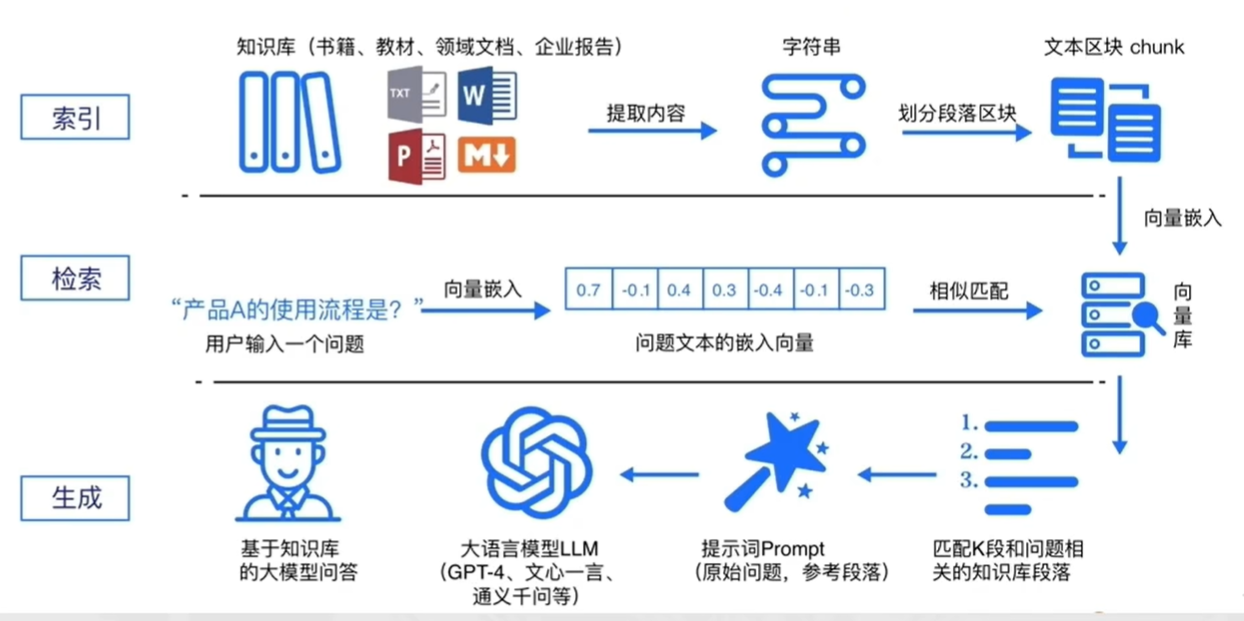
注:上图均来自于黑马程序员大模型RAG与Agent智能体项目实战教程
简单来说RAG工作分为两条线
- 离线流程-R(Retrieval检索):知识库预处理,通过查询各种的方式寻找文档/私有知识并加载,在分割,向量化之后形成向量数据库。
- 在线流程-A(Augmentation增强)G(Generation生成):用户提问->检索环节->Prompt融合->大模型回答
- 同时离线流程中的向量数据库会流向在线流程的检索环节。w
模型本质上就是用户输入,模型给出输出,用户能做的就是在输入上做功夫。
RAG 就是在向模型提问之前基于已有的知识库或文档内容做检索,确保向模型提问的内容更精准以及包含足够的信息量用以提供给模型。
RAG 的核心价值:
- 解决知识实效性问题:大模型的训练数据有截止时间,RAG 可以接入最新文档(如公司财报、政策文件),让模型输出 “与时俱进”。
- 降低模型幻觉:模型的回答基于检索到的事实性资料,而非纯靠自身记忆,大幅减少编造信息的概率。
- 无需重新训练模型:相比微调(Fine-tuning),RAG 只需更新知识库,成本更低、效率更高。
模型上下文搜索协议 MCP
MCP:model context protocol